
GPT_FILE 公式
使用 =GPT_FILE 就文件提问
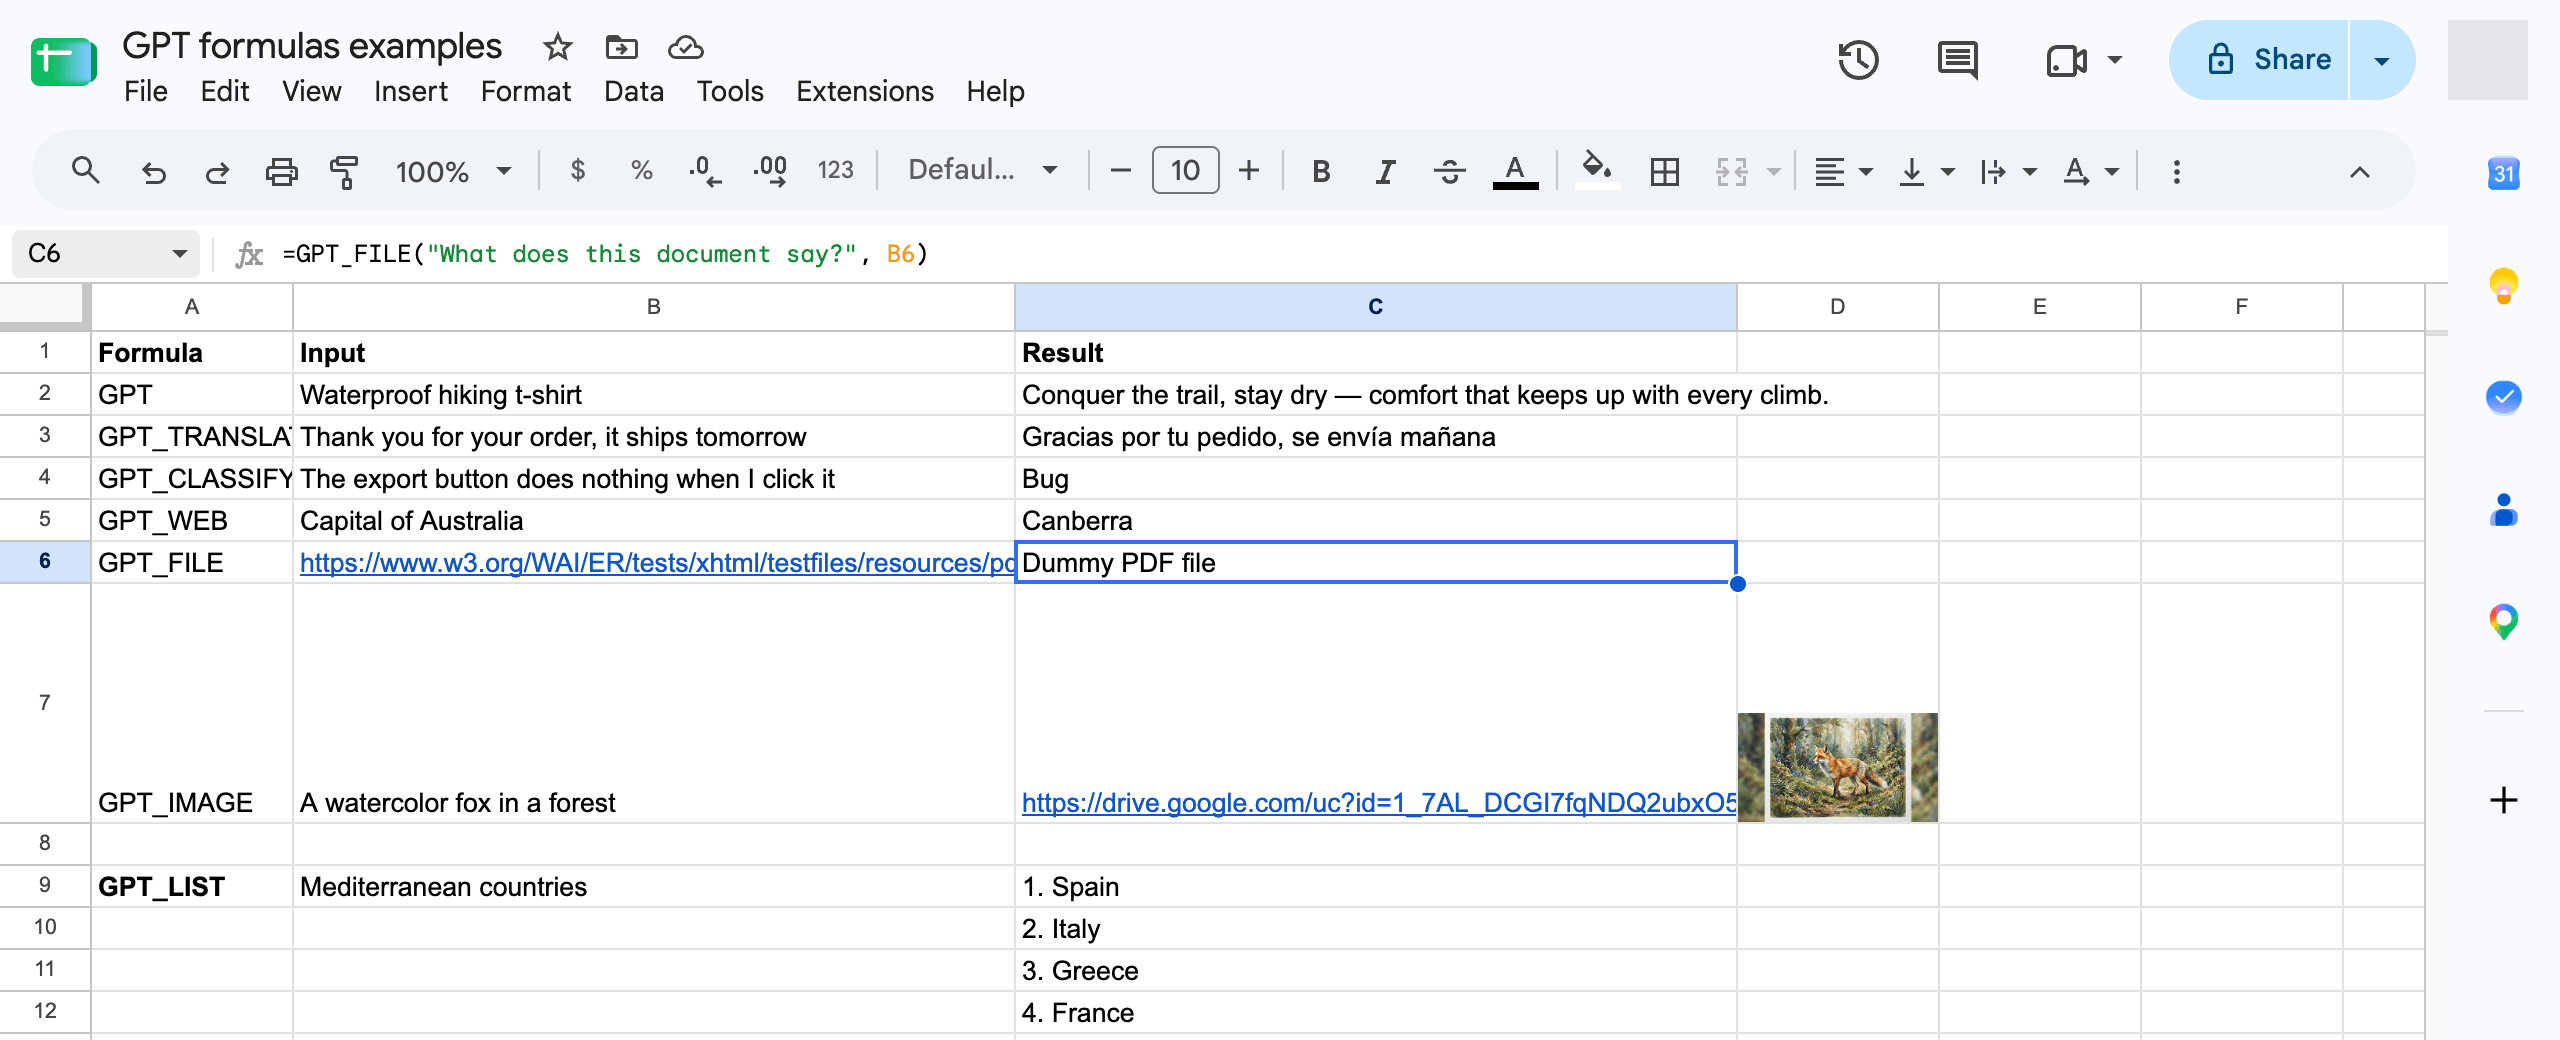
Section titled “使用 =GPT_FILE 就文件提问”=GPT_FILE 从 URL 获取文件,并根据其内容回答您的提示词:总结 PDF 合同、提取发票图片的总额、转录语音消息的主题、读取 DOCX。
=GPT_FILE(prompt, fileURL, temperature, model)
| 参数 | 说明 | 默认值 |
|---|---|---|
prompt |
对文件执行的操作(例如:“此发票的总额是多少?”)。必填 | |
fileURL |
包含 URL 的单元格,或用引号括起来的 URL。文件必须无需登录即可下载:公开链接、与“知道链接的任何人”共享的 Google 云端硬盘文件,或直接的文件 URL。必填 | |
temperature |
介于 0(无创造性)和 2(极具创造性)之间 | 0.5 |
model |
standard 或 advanced(付费计划)。用于文档搜索路由 |
standard |
示例:=GPT_FILE("Summarize this document in three bullet points", A2)
| 格式 | 读取方式 |
|---|---|
| 最多 20 页的 PDF | 由多模态模型整体读取 |
| 最多 20 MB 的图片(png、jpg、webp) | 由多模态模型整体读取 |
| 最多 20 MB 的音频(mp3)和视频(mp4) | 由多模态模型整体读取 |
| 超过 20 页的 PDF | 建立索引,然后根据您的提示词搜索最相关的段落 |
| Word (docx)、PowerPoint (pptx)、txt、md、csv、json、html、代码文件 | 建立索引,然后搜索 |
对于已建立索引的文件,提供给模型的段落上限约为 16,000 个字符,因此针对特定部分的问题比在超长文档上“总结所有内容”效果更好。
Media file is too large for GPT_FILE (max 20MB):压缩图片、音频或视频,或将其拆分。Failed to index file for search (…):无法读取文件;请检查 URL 是否直接下载文件以及格式是否受支持。- 出现登录页面或 HTML 而非文件:链接不是公开的。请使用“知道链接的任何人”共享文件,或使用直接下载 URL。
额度将按照模型处理文件和生成答案的实际成本收取,请参阅什么是额度?。