为什么我的额度消耗得这么快?
额度是模型成本的单位,而不是消息条数:一次请求的成本等于 AI 模型对该请求的实际计费。请参阅什么是额度?。当涉及以下高成本项目时,几轮对话可能会消耗大量额度。
消耗最多的操作
Section titled “消耗最多的操作”| 操作 | 昂贵的原因 |
|---|---|
| 高级模型 | 高级模型每 token 的成本是标准模型的 10 到 30 倍。模型根据公式("advanced")选择并显示在对话中;日常任务建议优先使用标准模型。 |
| 长上下文 | 模型读取的所有内容都会计入:整个文档、大型表格范围、长对话线程、20 页的 PDF。对长文件执行“总结此文件”比针对选中区域提问消耗更多额度。 |
| 代理运行 | “将这五份银行对账单提取到表格”包含多个步骤:读取每个文件、推理、写入单元格、检查结果。每个步骤都是一次模型调用。 |
| 网页搜索 | =GPT_WEB 和对话中的网页搜索会抓取页面并将内容发送给模型,每行或每个问题各一次。 |
| 图片 | 生成一张图片的消耗相当于数千条简短文本回答。 |
| 重试和错误 | 公式失败后重新运行时,每次到达模型的尝试都会被计费。 |
提示词和回答都会计入,而输出 token 的成本更高。
查看额度消耗去向
Section titled “查看额度消耗去向”打开 gpt.space/app/settings/subscription:额度卡片会显示当月用量与配额的对比、充值额度和奖励额度的余额,以及配额重置日期。
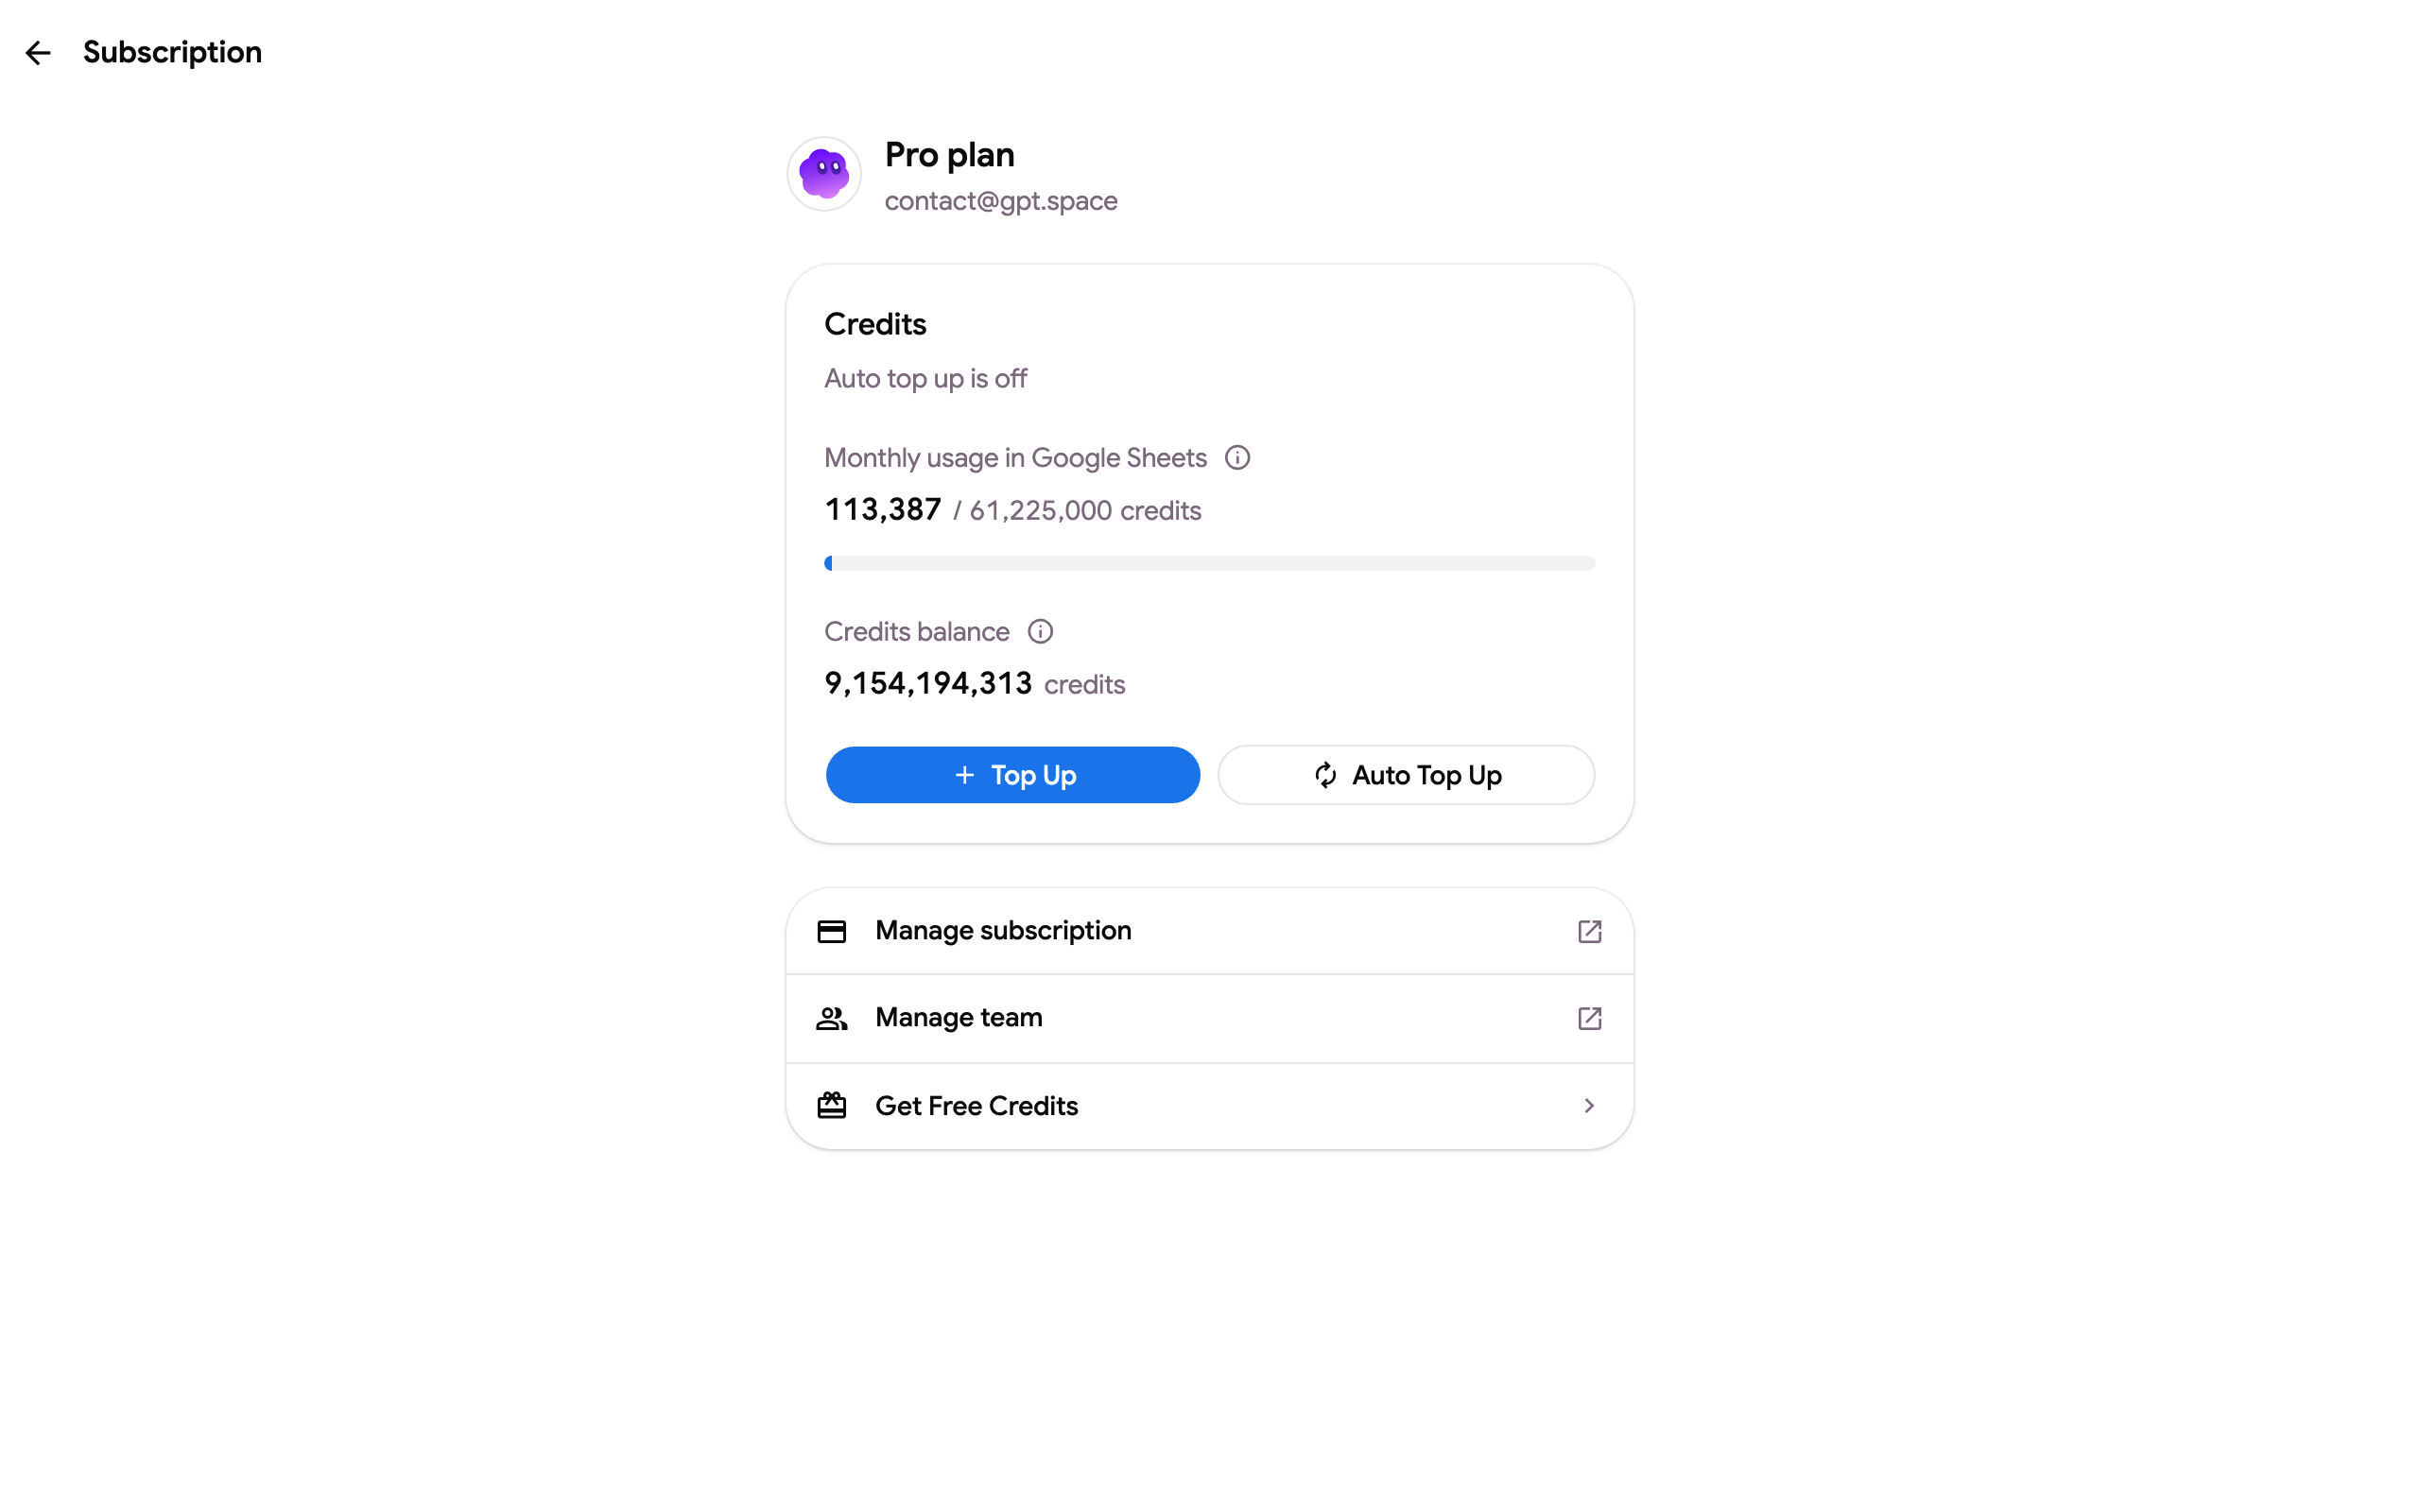
月度额度不会结转:未使用的额度在周期重置时过期。充值额度和奖励额度会保留,直到用完为止。
- 除非任务需要推理,否则使用标准模型;在 Sheets 中,可在公式设置中统一设置一次。
- 当只需要文档的一部分时,针对选中区域提问,而非整个文档。
- 在 Sheets 中保持较低的输出 token,并要求简短回答(“一个词”、“一个数字”)。
- 先对几行运行新公式,检查结果,再填充整列。
- 避免重复执行整列网页搜索:冻结结果,参见刷新或冻结 GPT 单元格。
- 在 Standard 和 Pro 套餐上,如果使用频率不高,可启用按量付费,而非升级到更大的套餐。
“我有额度但从未使用过”
Section titled ““我有额度但从未使用过””奖励额度和免费额度不会自行消失,但免费套餐的月度配额会在每个周期重置,套餐的月度额度是替换而非累加。如果余额与您的使用情况不符,请发送邮件至 contact@gpt.space,并附上账户邮箱:我们可以列出消耗额度的请求记录。