GPT_CLASSIFY formule
Tekst sorteren in je eigen categorieën met =GPT_CLASSIFY
Section titled “Tekst sorteren in je eigen categorieën met =GPT_CLASSIFY”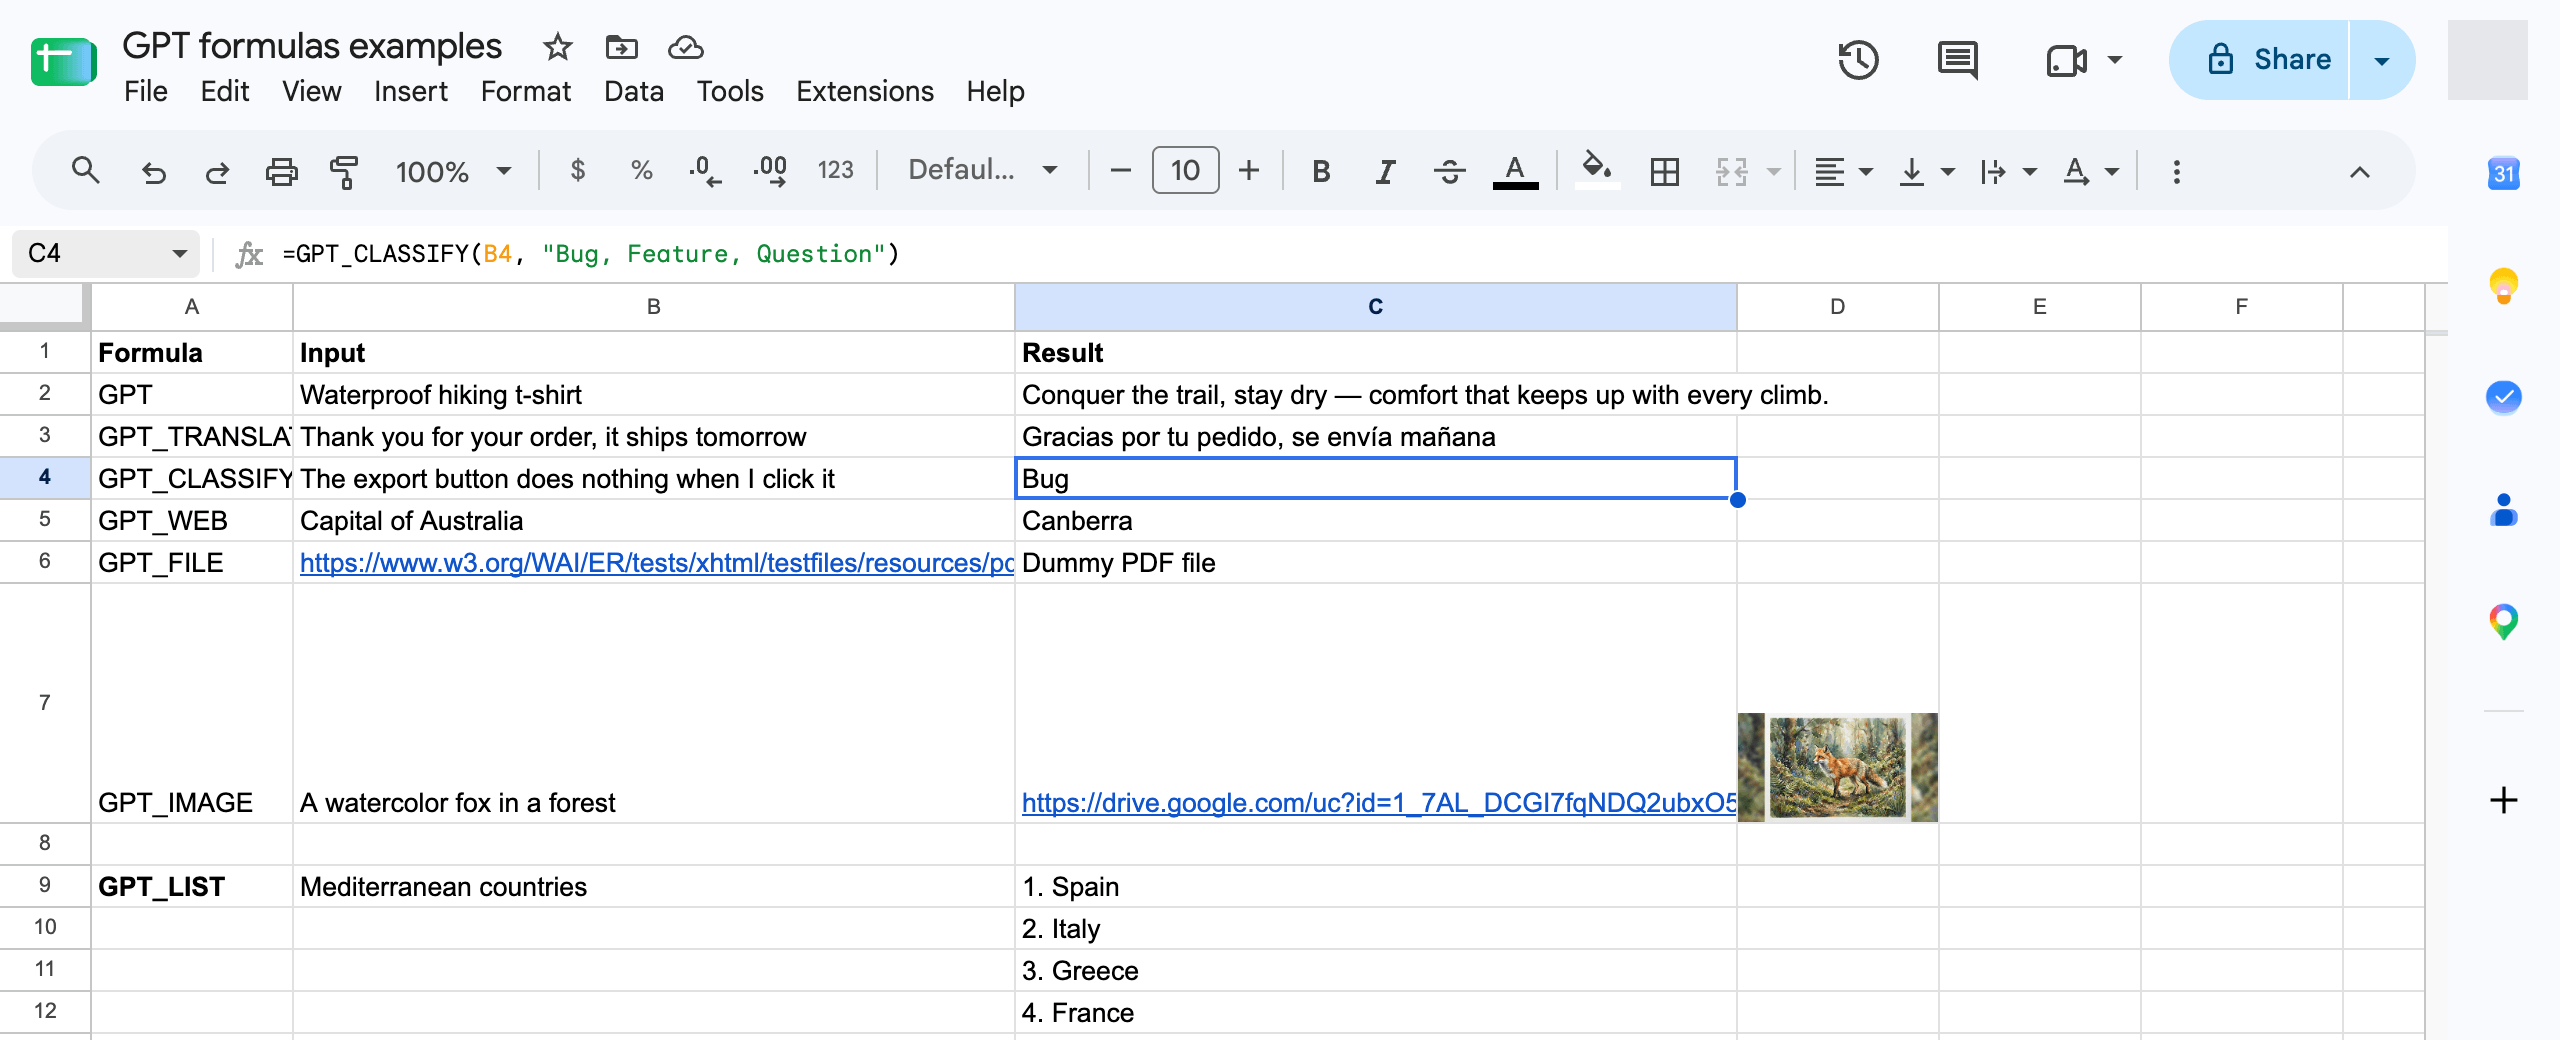
=GPT_CLASSIFY(value, categories, instructions, output, bypassCache)
| Parameter | Beschrijving | Standaardwaarde |
|---|---|---|
value | De te classificeren cel (bijv. A2), of een bereik van maximaal 100 cellen (bijv. A2:A50). Een bereik geeft één resultaat per cel, in dezelfde vorm. vereist | "" |
categories | Ofwel een kommagescheiden lijst (bijv. "Bug, Feature, Question") of een cellenbereik. Een bereik van één kolom bevat de labels; een bereik van twee kolommen bevat een label en de bijbehorende beschrijving (bijv. F2:G5). Beschrijvingen maken de classificatie aanzienlijk nauwkeuriger. vereist | "" |
instructions | Context voor de classificatie (bijv. "Supporttickets van een SaaS-product"). | "" |
output | label (de gekozen categorie), confidence (een score van 0 tot 1 voor de gekozen categorie), both (label en score in twee kolommen) of all (één score per categorie, in de volgorde van je categorieën). | label |
bypassCache | Negeer de cache en classificeer opnieuw. | false |
Voorbeelden
Section titled “Voorbeelden”| Formule | Resultaat |
|---|---|
=GPT_CLASSIFY(A2, "Bug, Feature, Question") |
Bug |
=GPT_CLASSIFY(A2, "Bug, Feature, Question", "Support tickets", "both") |
Bug | 0.94 |
=GPT_CLASSIFY(A2, F2:G5, , "all") |
één score per categorie, in F2:F5-volgorde |
=GPT_CLASSIFY(A2:A50, $F$2:$G$5) |
één label per rij, in één formule |
Tip: zet je categorieën in een bereik met een beschrijving naast elk label, bijvoorbeeld Bug | er is iets kapot, Feature | vraagt om een nieuwe mogelijkheid, Question | vraagt hoe iets moet worden gedaan. Verwijs daarna naar het bereik met $F$2:$G$5 zodat je de formule naar beneden kunt slepen.
Betrouwbaarheid en controle
Section titled “Betrouwbaarheid en controle”Elke classificatie geeft altijd de best passende categorie terug. Gebruik "both" om de betrouwbaarheid naast het label te krijgen en markeer rijen met een lage betrouwbaarheid voor menselijke controle met een filter of voorwaardelijke opmaak, of gebruik "all" om de volledige scoreverdeling te zien voor een heatmap.
Lege cellen geven een leeg resultaat. Identieke teksten in een bereik worden één keer geclassificeerd, en het opnieuw uitvoeren van een bereik classificeert alleen de cellen waarvan de tekst is veranderd.
Model en prijs
Section titled “Model en prijs”=GPT_CLASSIFY draait op TypeSafe Jev, een beslismodel dat een meerkeuzevraag beantwoordt met een kans per categorie. Het is sneller en ongeveer 10x goedkoper dan een tekstformule, en wordt belast tegen de werkelijke kostprijs van het model. Het is beschikbaar op elk abonnement.
Als het beslismodel niet beschikbaar is, valt de formule terug op het Standard tekstmodel zodat je werkblad om die reden nooit een foutmelding toont; de betrouwbaarheidsscore wordt dan leeg gelaten.