Công thức GPT_CLASSIFY
Phân loại văn bản theo danh mục tùy chỉnh với =GPT_CLASSIFY
Phần tiêu đề “Phân loại văn bản theo danh mục tùy chỉnh với =GPT_CLASSIFY”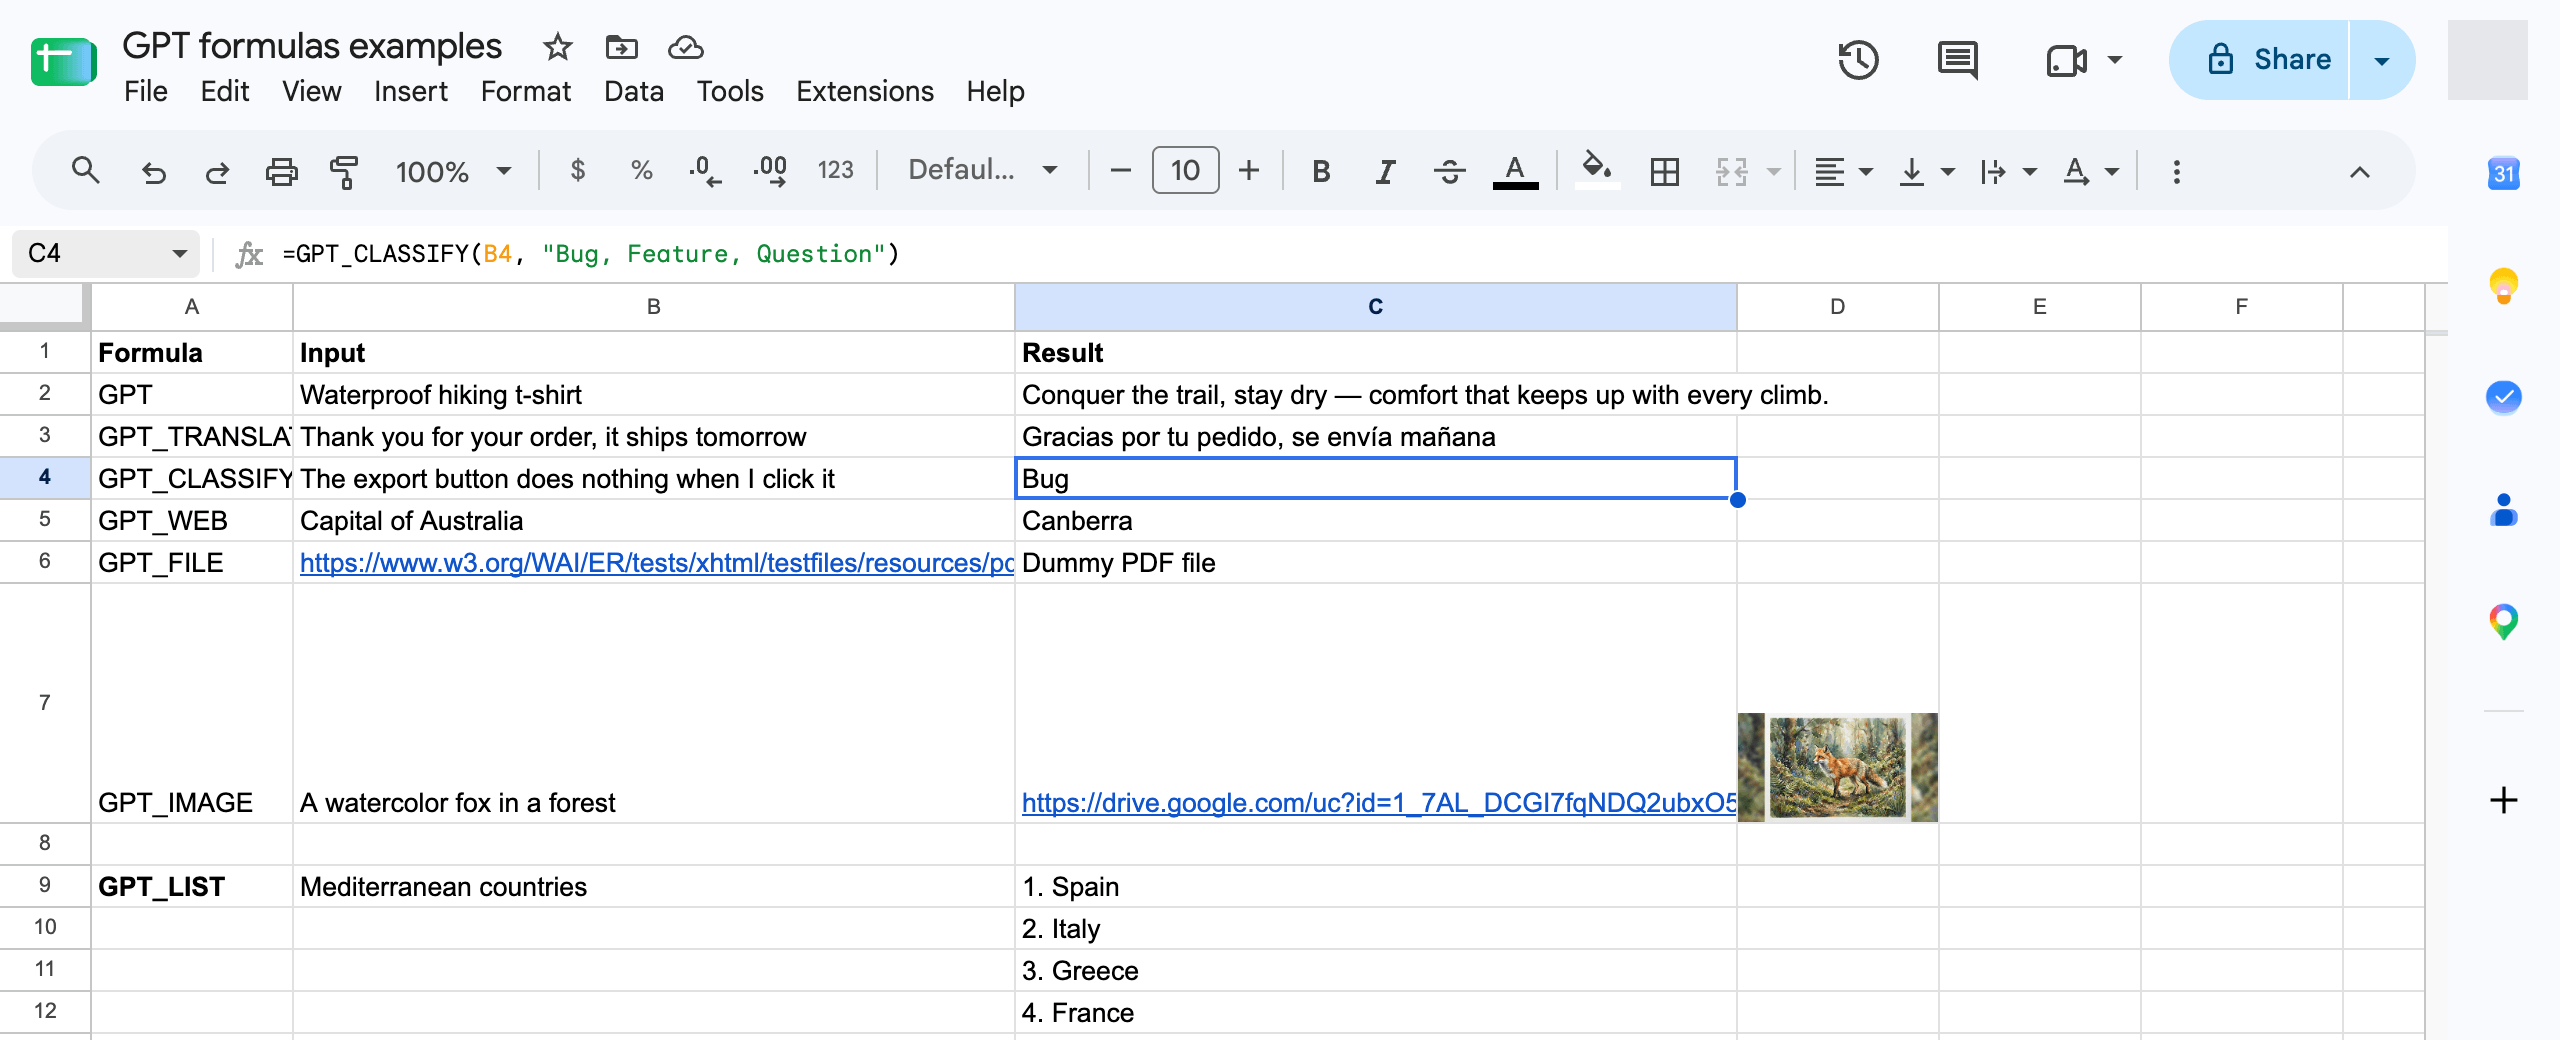
=GPT_CLASSIFY(value, categories, instructions, output, bypassCache)
| Tham số | Mô tả | Mặc định |
|---|---|---|
value | Ô cần phân loại (ví dụ: A2), hoặc một phạm vi tối đa 100 ô (ví dụ: A2:A50). Một phạm vi trả về một kết quả cho mỗi ô, với cùng hình dạng. bắt buộc | "" |
categories | Một danh sách phân tách bằng dấu phẩy (ví dụ: "Bug, Feature, Question") hoặc một phạm vi ô. Phạm vi một cột chứa các nhãn; phạm vi hai cột chứa nhãn và mô tả tương ứng (ví dụ: F2:G5). Mô tả giúp việc phân loại chính xác hơn đáng kể. bắt buộc | "" |
instructions | Ngữ cảnh cho bộ phân loại (ví dụ: "Phiếu hỗ trợ của một sản phẩm SaaS"). | "" |
output | label (danh mục được chọn), confidence (điểm từ 0 đến 1 của danh mục được chọn), both (nhãn và điểm trong hai cột) hoặc all (một điểm cho mỗi danh mục, theo thứ tự danh mục của bạn). | label |
bypassCache | Bỏ qua bộ nhớ đệm và phân loại lại. | false |
Ví dụ
Phần tiêu đề “Ví dụ”| Công thức | Kết quả |
|---|---|
=GPT_CLASSIFY(A2, "Bug, Feature, Question") |
Bug |
=GPT_CLASSIFY(A2, "Bug, Feature, Question", "Support tickets", "both") |
Bug | 0.94 |
=GPT_CLASSIFY(A2, F2:G5, , "all") |
một điểm cho mỗi danh mục, theo thứ tự F2:F5 |
=GPT_CLASSIFY(A2:A50, $F$2:$G$5) |
một nhãn cho mỗi dòng, trong một công thức duy nhất |
Mẹo: đặt danh mục của bạn trong một phạm vi kèm mô tả bên cạnh mỗi nhãn, ví dụ Bug | có thứ gì đó bị hỏng, Feature | yêu cầu một tính năng mới, Question | hỏi cách thực hiện việc gì đó. Sau đó tham chiếu phạm vi bằng $F$2:$G$5 để bạn có thể kéo công thức xuống dưới.
Độ tin cậy và xem xét
Phần tiêu đề “Độ tin cậy và xem xét”Mỗi lần phân loại luôn trả về danh mục khớp nhất. Sử dụng "both" để nhận điểm tin cậy bên cạnh nhãn và đánh dấu các dòng có độ tin cậy thấp để con người xem xét lại bằng bộ lọc hoặc định dạng có điều kiện, hoặc "all" để xem phân bố điểm đầy đủ cho một bản đồ nhiệt.
Ô trống trả về kết quả trống. Các văn bản giống nhau trong một phạm vi được phân loại một lần, và việc chạy lại một phạm vi chỉ phân loại những ô có văn bản thay đổi.
Mô hình và giá
Phần tiêu đề “Mô hình và giá”=GPT_CLASSIFY chạy trên TypeSafe Jev, một mô hình quyết định trả lời một câu hỏi trắc nghiệm với xác suất cho mỗi danh mục. Nó nhanh hơn và rẻ hơn khoảng 10 lần so với công thức văn bản, và được tính phí theo chi phí thực tế của mô hình. Nó có sẵn trên mọi gói.
Nếu mô hình quyết định không khả dụng, công thức sẽ chuyển sang mô hình văn bản Standard để bảng tính của bạn không bao giờ hiển thị lỗi vì lý do đó; khi đó điểm tin cậy sẽ để trống.