Rumus GPT_CLASSIFY
Urutkan teks ke dalam kategori Anda sendiri dengan =GPT_CLASSIFY
Section titled “Urutkan teks ke dalam kategori Anda sendiri dengan =GPT_CLASSIFY”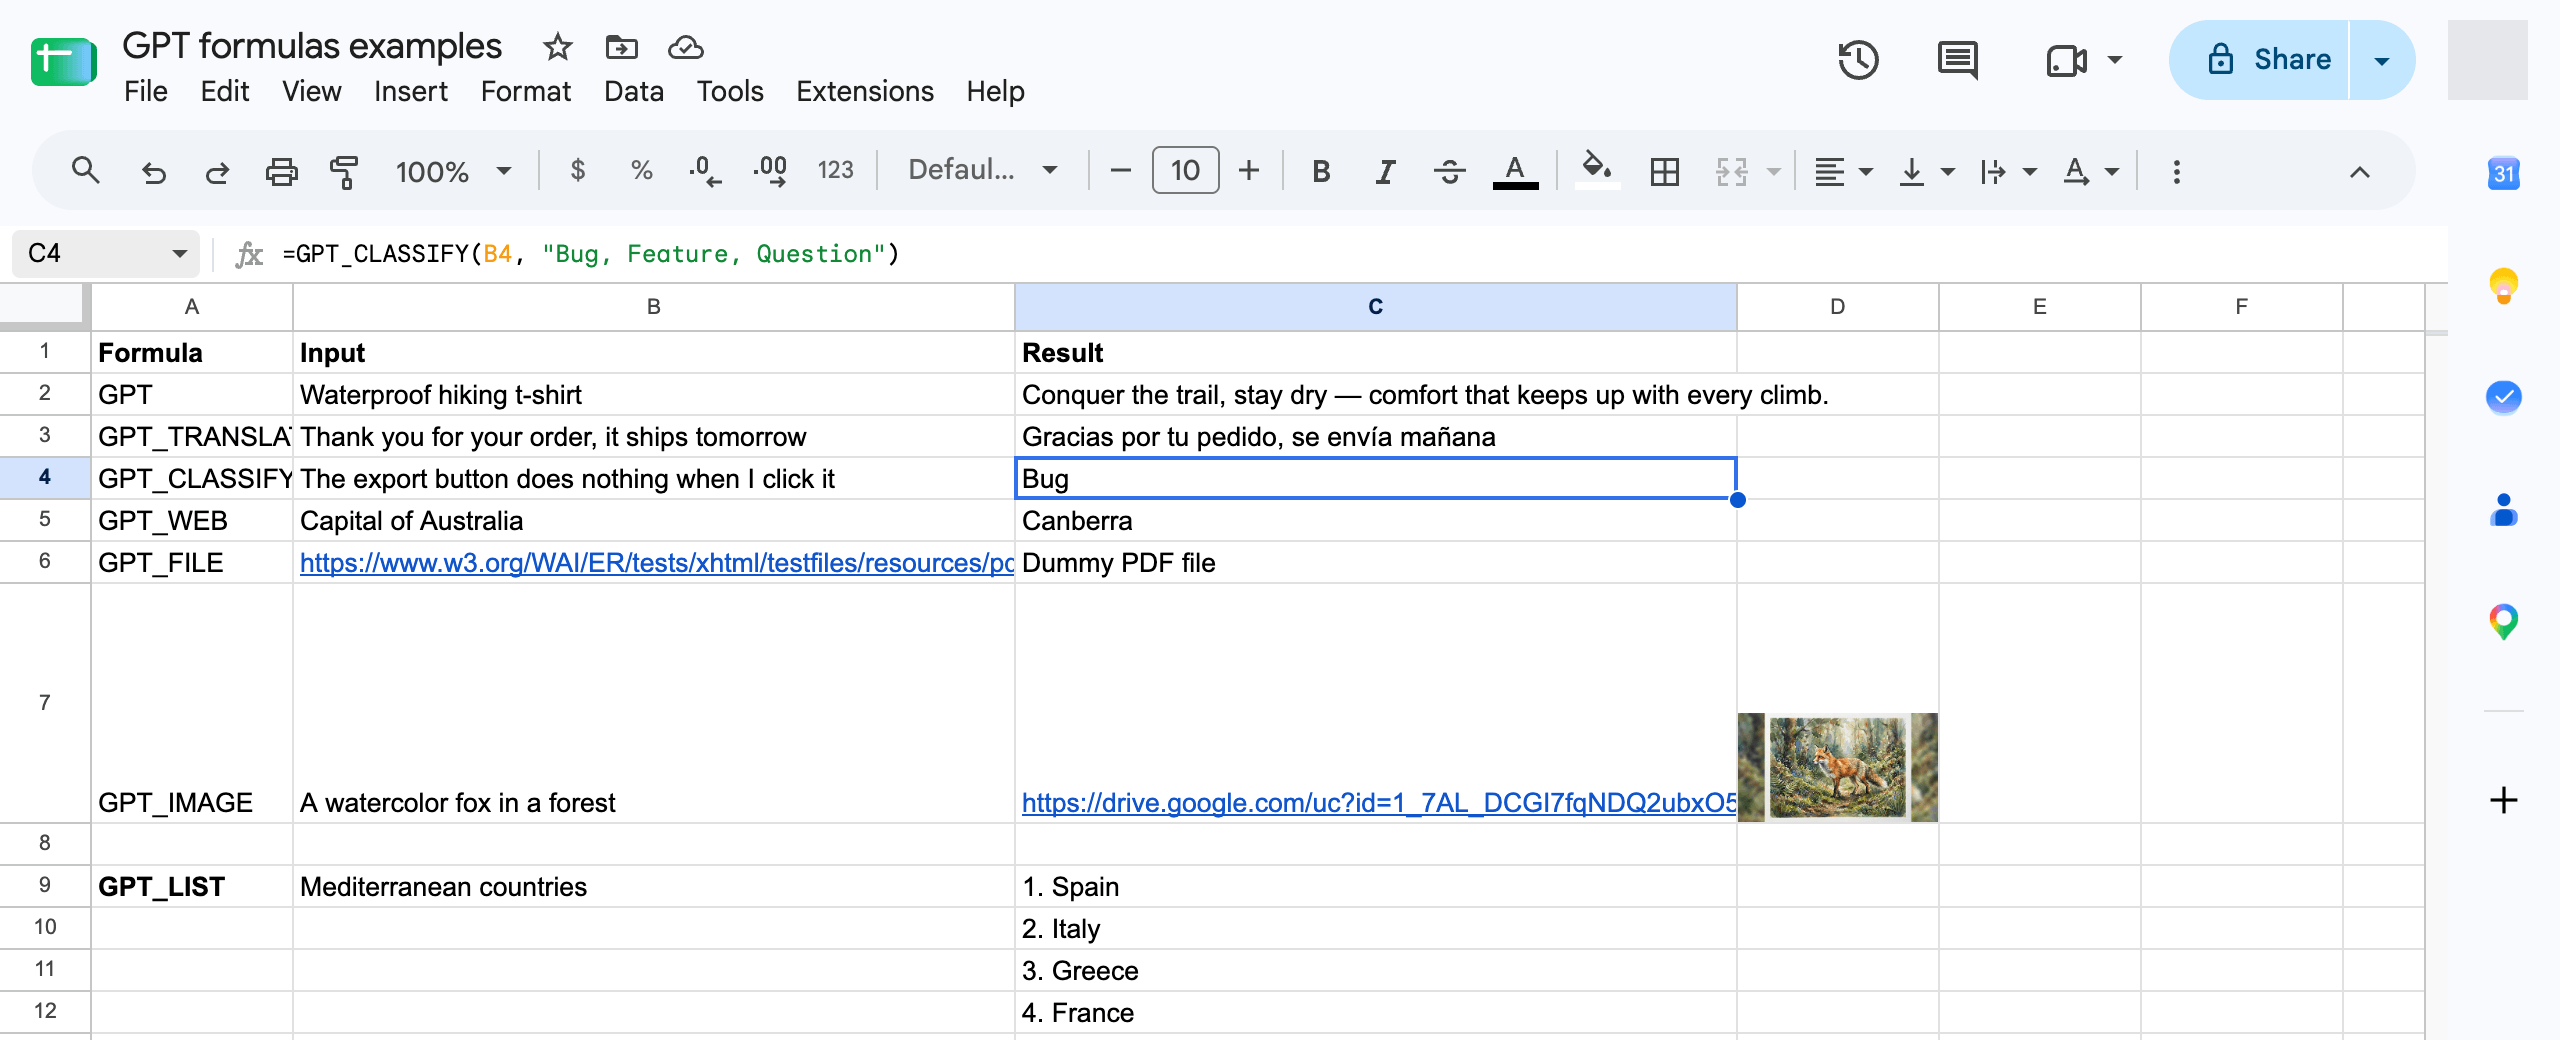
=GPT_CLASSIFY(value, categories, instructions, output, bypassCache)
| Parameter | Deskripsi | Default |
|---|---|---|
value | Sel yang akan diklasifikasikan (mis: A2), atau rentang hingga 100 sel (mis: A2:A50). Rentang mengembalikan satu hasil per sel, dalam bentuk yang sama. wajib | "" |
categories | Berupa daftar dipisahkan koma (mis: "Bug, Feature, Question") atau rentang sel. Rentang satu kolom menyimpan label; rentang dua kolom menyimpan label dan deskripsinya (mis: F2:G5). Deskripsi membuat klasifikasi jauh lebih akurat. wajib | "" |
instructions | Konteks untuk pengklasifikasi (mis: "Tiket dukungan produk SaaS"). | "" |
output | label (kategori yang dipilih), confidence (skor 0 hingga 1 untuk kategori yang dipilih), both (label dan skor dalam dua kolom) atau all (satu skor per kategori, sesuai urutan kategori Anda). | label |
bypassCache | Lewati cache dan klasifikasikan ulang. | false |
Contoh
Section titled “Contoh”| Rumus | Hasil |
|---|---|
=GPT_CLASSIFY(A2, "Bug, Feature, Question") |
Bug |
=GPT_CLASSIFY(A2, "Bug, Feature, Question", "Support tickets", "both") |
Bug | 0.94 |
=GPT_CLASSIFY(A2, F2:G5, , "all") |
satu skor per kategori, sesuai urutan F2:F5 |
=GPT_CLASSIFY(A2:A50, $F$2:$G$5) |
satu label per baris, dalam satu rumus |
Tips: letakkan kategori Anda dalam rentang dengan deskripsi di samping setiap label, misalnya Bug | something is broken, Feature | asks for a new capability, Question | asks how to do something. Lalu referensikan rentang tersebut dengan $F$2:$G$5 agar Anda dapat menarik rumus ke bawah.
Keyakinan dan peninjauan
Section titled “Keyakinan dan peninjauan”Setiap klasifikasi selalu mengembalikan kategori yang paling cocok. Gunakan "both" untuk mendapatkan skor keyakinan di samping label dan menandai baris dengan keyakinan rendah untuk ditinjau manusia dengan filter atau format bersyarat, atau "all" untuk melihat distribusi skor lengkap membuat heatmap.
Sel kosong mengembalikan hasil kosong. Teks yang identik dalam rentang diklasifikasikan sekali, dan menjalankan ulang rentang hanya mengklasifikasikan sel yang teksnya berubah.
Model & harga
Section titled “Model & harga”=GPT_CLASSIFY berjalan di TypeSafe Jev, model keputusan yang menjawab pertanyaan pilihan tunggal dengan probabilitas per kategori. Model ini lebih cepat dan sekitar 10x lebih murah daripada rumus teks, dan biayanya sama dengan biaya aktual model. Tersedia di semua paket.
Jika model keputusan tidak tersedia, rumus akan beralih ke model teks Standar sehingga lembar Anda tidak pernah menampilkan kesalahan karena alasan tersebut; skor keyakinan kemudian dibiarkan kosong.