Vzorec GPT_CLASSIFY
Třiďte text do vlastních kategorií pomocí =GPT_CLASSIFY
Sekce “Třiďte text do vlastních kategorií pomocí =GPT_CLASSIFY”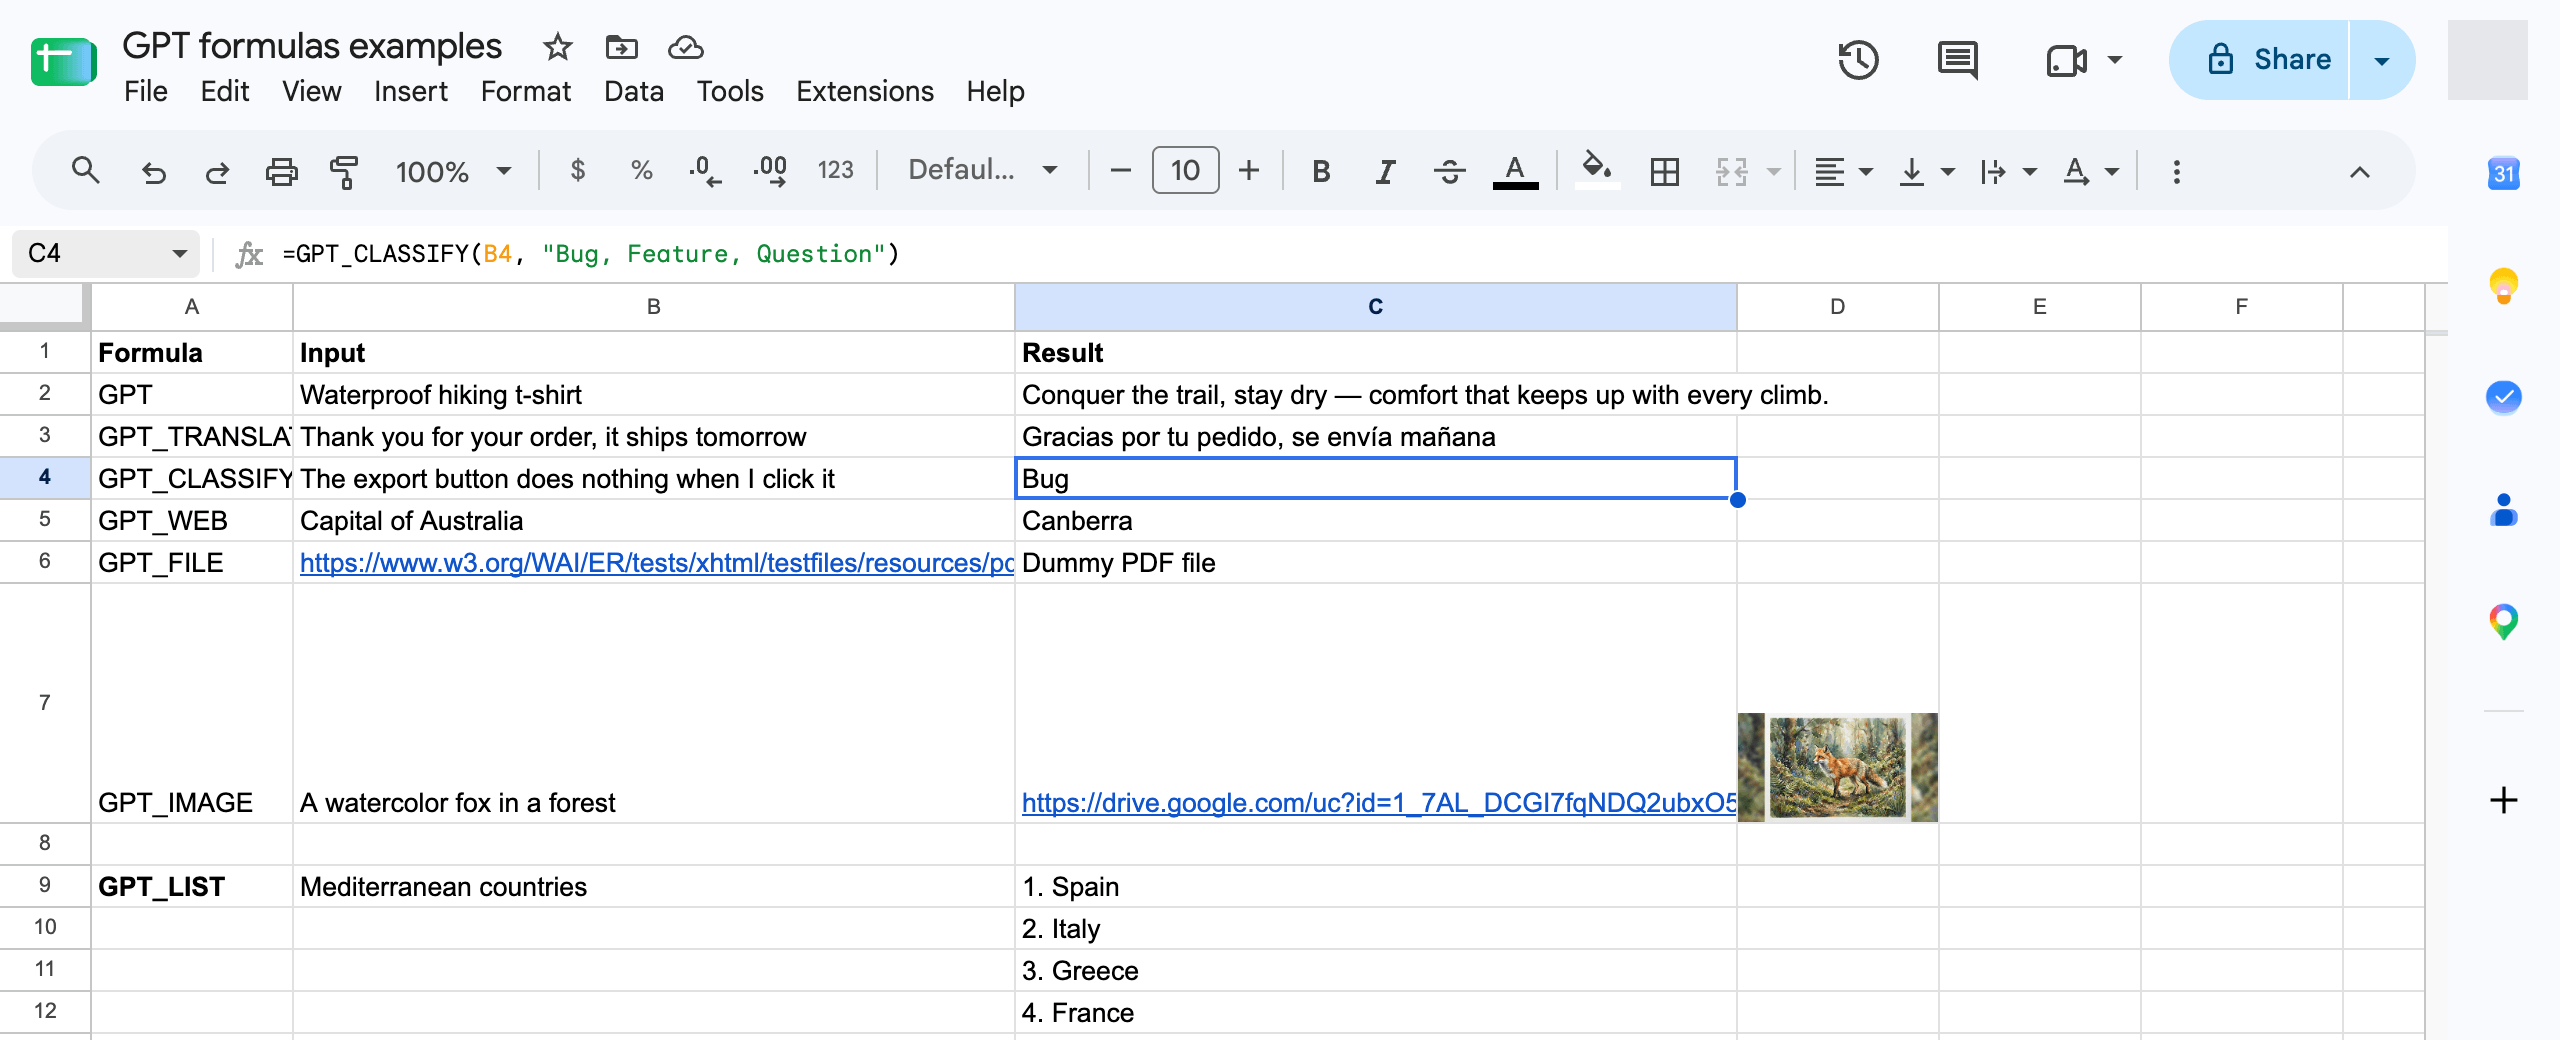
=GPT_CLASSIFY(value, categories, instructions, output, bypassCache)
| Parametr | Popis | Výchozí |
|---|---|---|
value | Buňka, kterou chcete klasifikovat (např.: A2), nebo oblast až 100 buněk (např.: A2:A50). Oblast vrátí jeden výsledek pro každou buňku, ve stejném tvaru. vyžadováno | "" |
categories | Buď čárkami oddělený seznam (např.: „Bug, Feature, Question") nebo oblast buněk. Jednosloupcová oblast obsahuje štítky; dvousloupcová oblast obsahuje štítek a jeho popis (např.: F2:G5). Popisy výrazně zvyšují přesnost klasifikace. vyžadováno | "" |
instructions | Kontext pro klasifikátor (např.: „Support tickets of a SaaS product"). | "" |
output | label (zvolená kategorie), confidence (skóre od 0 do 1 pro zvolenou kategorii), both (štítek a skóre ve dvou sloupcích) nebo all (jedno skóre pro každou kategorii, v pořadí vašich kategorií). | label |
bypassCache | Obejít mezipaměť a klasifikovat znovu. | false |
Příklady
Sekce “Příklady”| Vzorec | Výsledek |
|---|---|
=GPT_CLASSIFY(A2, "Bug, Feature, Question") |
Bug |
=GPT_CLASSIFY(A2, "Bug, Feature, Question", "Support tickets", "both") |
Bug | 0.94 |
=GPT_CLASSIFY(A2, F2:G5, , "all") |
jedno skóre pro každou kategorii, v pořadí F2:F5 |
=GPT_CLASSIFY(A2:A50, $F$2:$G$5) |
jeden štítek pro každý řádek, v jednom vzorci |
Tip: umístěte své kategorie do oblasti s popisem vedle každého štítku, například Bug | něco je rozbité, Feature | žádost o novou funkci, Question | dotaz, jak něco udělat. Pak na oblast odkazujte pomocí $F$2:$G$5, abyste vzorec mohli rozšířit dolů.
Spolehlivost a kontrola
Sekce “Spolehlivost a kontrola”Každá klasifikace vždy vrátí nejlépe odpovídající kategorii. Použijte "both", abyste získali spolehlivost vedle štítku a mohli označit řádky s nízkou spolehlivostí pro lidskou kontrolu pomocí filtru nebo podmíněného formátování, nebo "all", abyste viděli úplné rozložení skóre pro heatmapu.
Prázdné buňky vracejí prázdný výsledek. Shodné texty v oblasti se klasifikují jednou a opětovné spuštění oblasti klasifikuje pouze buňky, jejichž text se změnil.
Model a ceny
Sekce “Model a ceny”=GPT_CLASSIFY běží na TypeSafe Jev, rozhodovacím modelu, který odpovídá na otázku s jednou volbou pravděpodobností pro každou kategorii. Je rychlejší a zhruba 10krát levnější než textový vzorec a účtuje se za skutečné náklady modelu. Je dostupný v každém tarifu.
Pokud rozhodovací model není dostupný, vzorec přejde na standardní textový model, takže váš sešit nikdy z tohoto důvodu nezobrazí chybu; skóre spolehlivosti je pak ponecháno prázdné.